Алексей Черкасов Python · AI/LLM · RAG

Автоматизирую рутину бизнеса с помощью новых технологий

Снимаю с компаний ручную работу и собираю рабочие AI-продукты: RAG-системы, Telegram-ботов с памятью, генераторы документов. От задачи до прототипа на ваших данных — за дни, а не месяцы.

Алексей Черкасов
40 мин → 15 секподготовка документа
Каждый ответ со ссылкойRAG без выдумок
О себе

Нахожу ручную работу в процессах и перекладываю её на код

Разбираюсь, где в вашем процессе часы уходят на повторяющиеся действия, и снимаю эту работу на код. На выходе — не презентация, а работающий продукт на ваших данных: генератор документов, база знаний по внутренним регламентам, бот-ассистент.

Прототип за дни, а не месяцыРаботаю AI-инструментами разработки, поэтому до рабочей демонстрации на ваших данных доходит быстро.
Считаю окупаемость до стартаЕсли автоматизация не отобьётся, скажу об этом прямо, а не буду продавать разработку.
Отдаю с документациейКод с README, запускается в Docker, ваша команда сможет работать с ним без меня.
Направления

Чем могу быть полезен

Автоматизация документов

Собираю готовые документы из сырых данных: транскриптов, переписок, брифов. Отчёт, карточка товара или ТЗ формируются сами — в моём кейсе подготовка сократилась с 40 минут до 15 секунд.

LLM · Jinja2 · WeasyPrint

Базы знаний (RAG)

Отвечает строго по вашим документам и показывает источники — без выдумок. Если ответа в базе нет, система честно об этом скажет. Расход токенов и стоимость запросов видно отдельно.

RAG · ChromaDB · OpenAI

Telegram-боты

Не бот с кнопками, а ассистент с долговременной памятью: помнит, что вы обсуждали раньше, и не заставляет объяснять контекст заново.

Pinecone · OpenAI Embeddings
Кейсы

Что уже работает

Отчёт по диалогу с клиентом Бриф на дизайн сайта со сгенерированным превью Карточка товара для маркетплейса
AI Report Generator · Python · Flask · WeasyPrint
Кейс 01 · Генерация документов

AI-генератор бизнес-отчётов

Три режима с одним входом: транскрипт разговора превращается в готовый PDF.

40 мин → 15 секна один документ

Задача

Менеджеры вручную собирали отчёты по итогам разговоров с клиентами: 40 минут на документ, структура у каждого своя, поля регулярно забывались.

Что сделал

Сервис принимает транскрипт, LLM выделяет из него поля, шаблоны Jinja2 и WeasyPrint собирают PDF. Три режима: отчёт по клиенту, бриф на дизайн сайта с превью-картинкой, карточка товара для маркетплейса. Встраивается в чужой процесс через REST.

Результат

40 минут ручной работы стали 15 секундами ожидания. Структура документа одинаковая у всех сотрудников, обязательные поля не теряются.

Что это дало клиенту

Менеджер не пишет документ, а проверяет готовый. Качество перестало зависеть от того, кто именно составлял отчёт, а освободившиеся часы ушли на работу с клиентами.
LLM-промптингFlaskJinja2WeasyPrintREST API
Роль: самостоятельно
Код на GitHub →
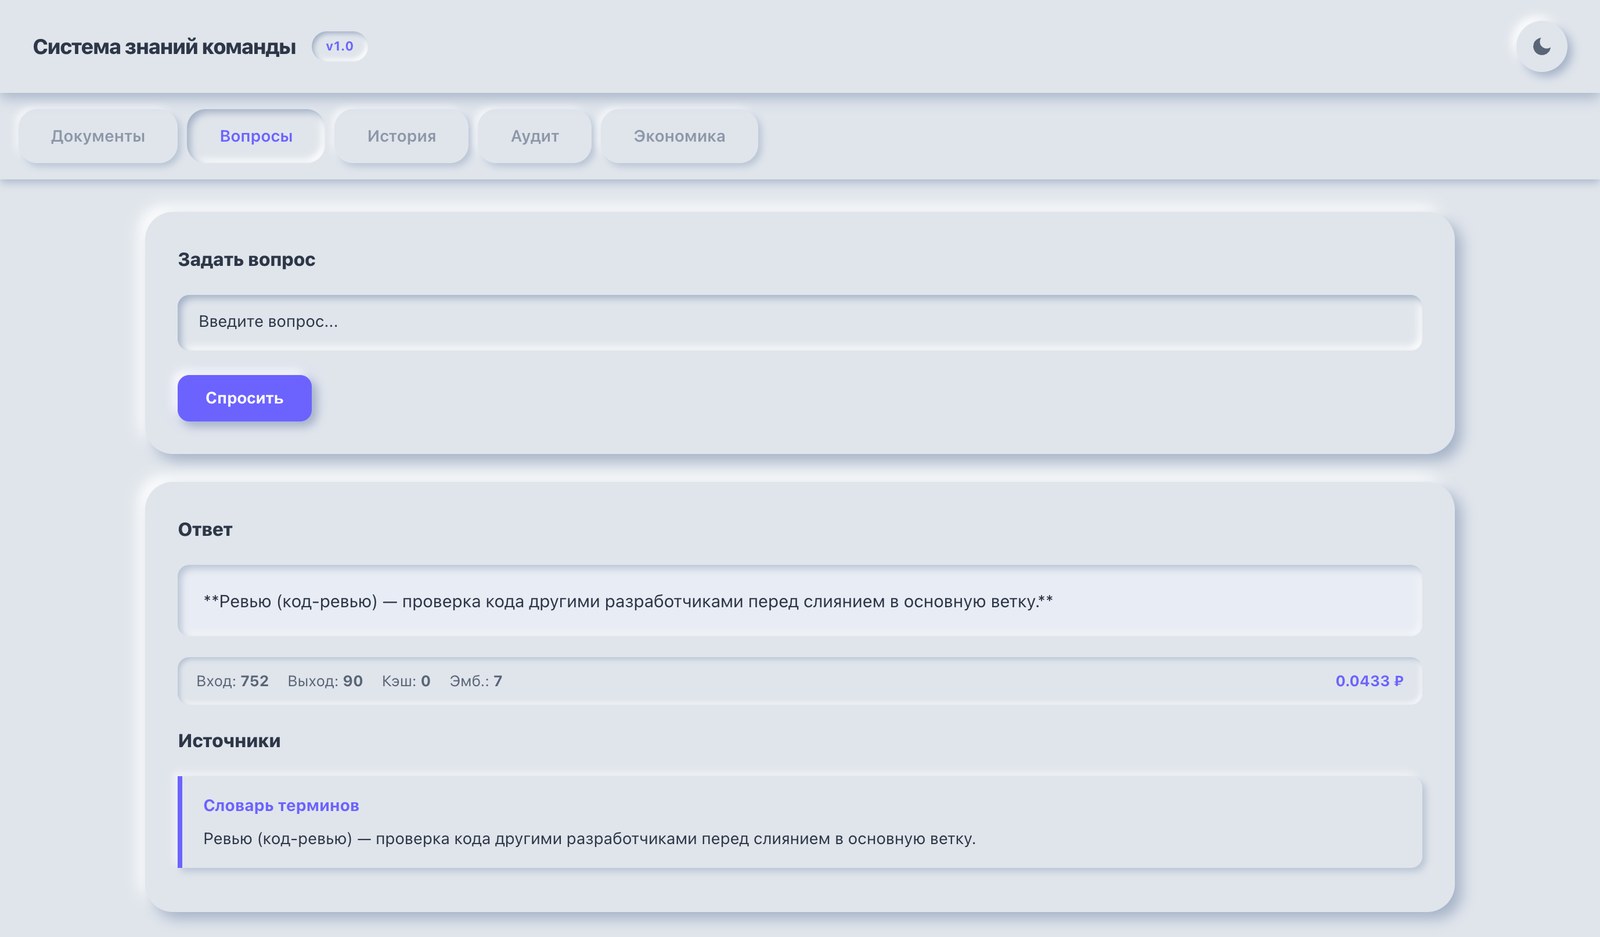
Ответ системы знаний со ссылкой на источник
Team Knowledge Base · FastAPI · RAG · ChromaDB · Docker
Кейс 02 · База знаний

Система знаний команды

Отвечает по внутренним документам и показывает источник каждого утверждения.

0.04 ₽ за ответс учётом эмбеддингов и токенов

Задача

Регламенты и инструкции разбросаны по файлам, сотрудники идут с вопросами в чат к коллегам. Обычный чат с LLM здесь опасен: он отвечает уверенно, но выдумывает.

Что сделал

FastAPI и RAG: документы (DOC, DOCX, PDF, TXT, MD) разбираются и ложатся в ChromaDB. Ответ собирается только из найденных фрагментов и идёт с цитатами. Если данных в базе нет — система говорит «данных недостаточно» и помечает вопрос для ручной проверки. Пять вкладок панели: документы, вопросы, история, аудит, экономика.

Результат

Каждый ответ подкреплён источником, спорные вопросы попадают в отдельный список. Расход на токены виден по каждому запросу. Поднимается в Docker одной командой, есть REST API и выгрузка истории в CSV.

Что это дало клиенту

Новый сотрудник находит ответ в регламенте, а не дёргает опытных. А список вопросов, на которые система не смогла ответить, — это готовый перечень того, что нужно дописать в базу знаний.

FastAPIRAGChromaDBPyMuPDFDockerУчёт стоимости
Роль: самостоятельно
Код на GitHub →
Telegram сообщение боту Поиск в памяти Pinecone, cosine GPT-4o ответ по контексту Ответ в чат с учётом истории новые факты сохраняются обратно в память
Telegram AI Assistant · Pinecone · OpenAI Embeddings
Кейс 03 · Ассистент

Telegram-ассистент с долговременной памятью

Диалог не начинается с нуля: бот помнит, что обсуждали раньше.

Помнит контекстмежду сессиями, отдельно по каждому

Задача

Обычный бот с LLM забывает всё, как только диалог прервался: человеку приходится заново объяснять, о чём он и что уже рассказывал.

Что сделал

Каждое сообщение превращается в эмбеддинг и ищется в Pinecone по косинусной близости. Релевантные фрагменты уходят в промпт как контекст. Новые факты добавляются, похожие обновляются, незначимые пропускаются. Память разделена по user_id — собеседники не видят чужие данные.

Результат

Бот помнит сказанное между сессиями и не задаёт один и тот же вопрос дважды. Порог похожести настраивается, а что сохранено, обновлено или пропущено — видно в логах.

Что это дало клиенту

Ассистент узнаёт постоянных клиентов и не заставляет их повторяться. Это фундамент, на который дальше наращиваются сценарии: приём заявок, квалификация лидов, поддержка.

PineconeOpenAI EmbeddingsTelegram Bot APIВекторный поиск
Роль: самостоятельно
Код на GitHub →
Процесс

Как я работаю

Погружение

Выясняю бизнес-задачу и ищу боль.

Архитектура

Подбираю стек под кейс и бюджет.

Разработка

Чистый код с документацией.

Демонстрация

Прототип на реальных данных.

Запуск

Деплой и интеграция.

Связь

Расскажите про задачу

Опишите, что нужно автоматизировать. Скажу, реально ли это сделать, сколько займёт и что получится на выходе. Если задача не под мои руки — так и скажу. Отвечаю в течение 2–4 часов в рабочее время (Екатеринбург, UTC+5).